K-means Clustering merupakan salah satu metode clustering non hirarki yang berusaha mempartisi data yang ada ke dalam bentuk satu atau lebih cluster. Metode ini mempartisi data ke dalam cluster sehingga data yang memiliki karakteristik yang sama dikelompokkan ke dalam satu cluster yang sama dan data yang mempunyai karateristik yang berbeda di kelompokan ke dalam cluster yang lain.
Bagaimana Proses K-Mean Clustering itu???
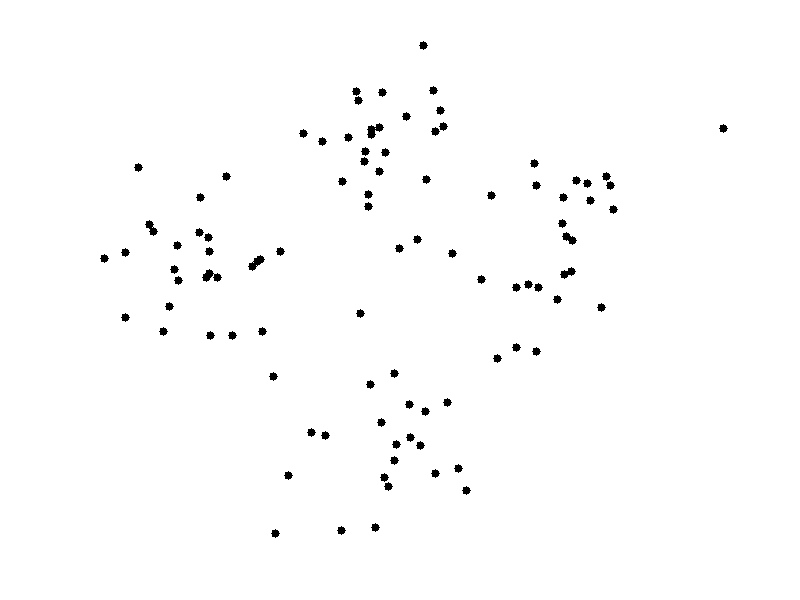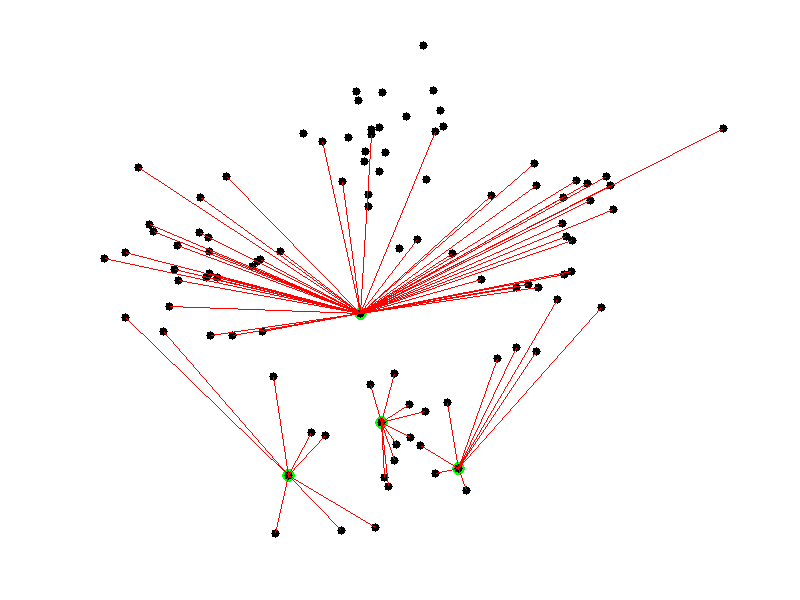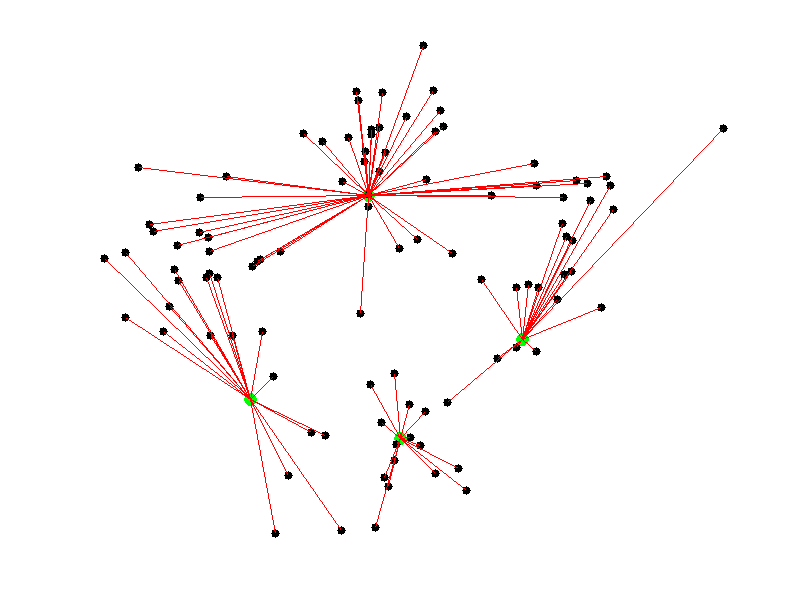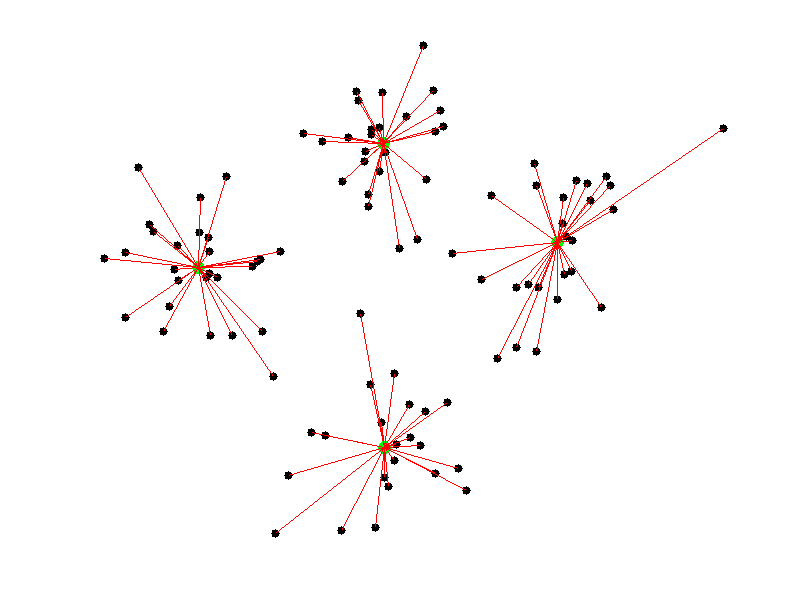

Secara umum proses dasar dari K-Means Clustering adalah sebagai berikut
- Tentukan jumlah cluster
- Alokasikan data ke dalam cluster secara random
- Hitung centroid/rata-rata dari data yang ada di masing-masing cluster
- Alokasikan masing-masing data ke centroid/rata-rata terdekat
- Kembali ke Step 3, apabila masih ada data yang berpindah cluster atau apabila perubahan nilai centroid, ada yang di atas nilai threshold yang ditentukan atau apabila perubahan nilai pada objective function yang digunakan di atas nilai threshold yang ditentukan
Hasil dari K-Mean Clustering adalah:
- Centroid dari cluster K, yang dapat digunakan untuk memberi label data baru
- Label untuk data pelatihan (setiap titik data ditugaskan ke satu clusters)
Contoh : Menerapkan K-Means Clustering Pada Datasets Iris
Mari kita lihat langkah-langkah tentang bagaimana algoritma K-means Clustering bekerja menggunakan Software R :
Langkah 1: Install dan Panggil Packages
Sebelum memulai untuk mengkluster , alangkah baiknya kita menginstall packages terlebih dahulu dengan syntax :
#== Install dan Panggil Packages ==#
Install.packages("tidyverse")
library(tidyverse)
Install.packages("cluster")    #Algoritma klastering
library(cluster)
Install.packages("factoextra") #Algoritma klastering dan visualisasi
library(factoextra)

Langkah 2: Loading Datasets Iris
Memanggil data iris di lembar kerja R dengan syntax :
#== Load Data ==#
data <- iris      #Load data Iris dengan nama 'data'
View(data)        #Melihat data
str(data)         #Melihat struktur data
head(data)        #Melihat 5 data teratas
summary(data) #Deskriptif data 


Diketahui dari datasets iris ada jumlah data sebanyak 150 data dengan 5 variabel, yaitu variabel Sepal.Length , Sepal.Width, Petal.Length, Petal.Width, dan Species, dan untuk variabel pecies terdapat tiga kela yaitu setosa, versi color dan virginic
Langkah 3 : Standarisasi Data
Standarisasi data hanya digunakan ketika datanya numerik. Sehingga Kides akan memanggil data untuk kolom 1 sampai 4 saja, dimana kolom 5 datanya tidak numerik jadi tidak digunakan berikut syntax yang digunakan :
#== Standarisasi Data ==#
data2=data.frame(data[1:4])   #Mengambil kolom yang digunakan
data2
datafix <- scale(data2)       #Standarisasi atau scalling  data
datafix


Fungsi scale merupakan fungsi untuk menyamakan satuan dari datanya.
Langkah 4 : Nilai K Optimum dengan Beberapa Metode
Selanjutnya akan mencari nilai k optimum, karena analisis k-means merupakan analisis non hirarki, maka nilai k ditentukan sendiri oleh peneliti , disini Kides menggunakan nilai k=3, namun untuk membuktikan nilai k yang digunakan paling optimal bisa dengan membandingkan tiga metode yaitu metode wss, sillhoutten, dan gap_statistic dengan syntax :
#== Mencari Nilai K Optimal ==## METODE  ELBOW atau WSS
fviz_nbclust(datafix, kmeans, method = "wss")# METODE SILHOUETTE
fviz_nbclust(datafix, kmeans, method = "silhouette")# METODE GAP STATISTIC
dim(data2)
set.seed(9999)      #Mengunci data ,nilainya ditentukan sendiri
gap_stat <-clusGap(datafix, FUN=kmeans, nstart=25, K.max=10, B= 150)
fviz_gap_stat(gap_stat)
Dari ketiga metode yang digunakan, kemudian dapat menentukan jumlah k yang optimal , jika ketiga metode menghasilkan nilai k yang sama maka nilai k yang didapat dari tiga metode tersebut yang digunakan, namun jika terdapat nilai k yang berbeda di salah satu metode nya, maka digunakan nilai k yang paling banyak sama untuk metode terbanyak, misal dari 3 metode 2 metode menghasilkan nilai k=3 dan 1 metode menghasilkan nilai k=2, maka k yang digunakan adalah 3.


Untuk penentuan nilai K dengan metode wss dengan melihat grafik yang pergerakannya mulai landai dari yang pertama setelah curam. Dari gambar dapat dilihat bahwa grafik yang pergerakannya landai pertama yaitu pada angka 3–4, berarti nilai K optimum metode wss adalah 3 .


Untuk penentuan nilai K pada metode silhouette , dilihat dari garis tertinggi atau melihatnya dengan melihat garis yang paling optimum. Dari gambar diatas , diketahui nilai K yang optimum adalah 2, namun ada opsional lain yaitu menentukan nilai K dengan menggunakan grafik paling tinggi berikutnya setelah grafik paling tinggi pertama yakni grafik tertingi kedua , yaitu di angka 3, berarti nilai K optimum metode silhouette adalah 3 .


Untuk penentuan nilai K optimum metode GAP Statistic / gap_stat dilihat dari garis yang dihubungkan dengan garis putus-putus. Garis yang dimaksud pada hasil metode gap_stat menunjukkan di angka 10 namun jika di logikakan, dengan jumah data 150 jika dilakukan pengklasteran sebanyak 10 terlalu banyak sehingga dilihat kembali bahwa garis yang tertinggi lainnya yaitu 3 , hal ini berarti nilai K optimum metode gap_stat adalah 3 .
**Jadi dapat disimpulkan bahwa dengan menggunakan 3 metode , nilai K optimum = 3
Langkah 5: Mengkluster dengan K-Means
Setelah didapatkan nilai k optimum dari ketiga metode, selanjutnya praktikan akan membuat cluster k-means dengan syntax :
#== Membuat Cluster K Means ==#
final <- kmeans(datafix, 3)
print(final)
fviz_cluster(final, data = datafix)
    iris %>%
    mutate(Cluster = final$cluster) %>%
    group_by(Cluster) %>%
    summarise_all("mean")

Dengan menggunakan k=3 ,diketahui cluster 1 memiliki jumlah data sebesar 53 , cluster 2 memiliki jumlah data sebesar 47 , dan cluster 3 memiliki jumlah data sebesar 50. Untuk penentuan data 1 masuk ke cluster mana, data 2 masuk ke cluster mana, sampai data ke 150 masuk ke cluster mana dengan melihat clustering vector nya. Dimana dari hasil diketahui bahwa untuk data 1 ampai data ke 50 masuk ke cluster 1, data 51–53 masuk ke cluster 2, data 54–56 masuk ke cluster 3, data ke 57 masuk ke cluster 2, dan seterunya sampai data ke 150. Setelah diketahui bahwa data 1–150 masuk ke cluster mana, selanjutnya didapatkan nilai within cluster sum of squares dari cluster k-means dengan k=3 yaitu untuk cluster 1 sebesar 44.0854, cluster 2 sebesar 47.45019, dan cluster 3 sebesar 47.35062. Dengan nilai between_SS atau between sum of squares dibagi nilai total_SS sebesar 76.7%.


Visualisasi dapat digunakan untuk mengetahui persebaran data berdasarkan pengelompokan cluster nya, dimana untuk cluster 1 berwarna merah dengan anggota cluster yaitu data 16, 34, 33, 15, 17, 6 dan lain-lain yang masih di warna merah, cluster 2 berwarna hijau dengan anggota cluster yaitu data 13, 118, 110, 86, 57, 51 dan lain-lain yang masih di warna hijau, dan cluster 3 berwarna biru dengan anggota kelompoknya yaitu data 61, 94, 58, 99, 147, 88 dan lain-lain yang masih di warna biru.
link youtube
https://www.youtube.com/watch?v=VdPYU8QAnzU

Tidak ada komentar:
Posting Komentar